(Essayez l'IA de Yiaho, c'est gratuit !)
Le 25 août 2026, OpenAI a publié les premiers résultats mesurés de Jalapeño, sa puce d’inférence conçue avec Broadcom. Sur trois modèles à poids ouverts, GPT-OSS 120B, DeepSeek R1 670B et Kimi K2.5 1T, la puce revendique de 1,5 à 1,9 fois plus de travail d’IA par watt que les accélérateurs Nvidia comparés, et une latence de bout en bout 1,7 à 3,6 fois plus basse. Le déploiement, annoncé d’ici la fin 2026, n’a pas encore commencé : il s’agit d’un projet planifié, qui ne coupe pas le lien avec Nvidia.
- Jalapeño est une puce d’inférence, pas une puce d’entraînement : elle sert les réponses des modèles, elle ne les fabrique pas.
- Le benchmark est public (InferenceX, développé par SemiAnalysis) mais les mesures sont publiées par OpenAI lui-même.
- Le « 1,9 fois » des gros titres est le cas le plus favorable : selon les modèles, le gain va de 1,5 à 1,9 fois au pic de débit.
- Pour l’utilisateur, la promesse est indirecte : des réponses plus rapides, des agents plus fiables et, à terme, un coût de service plus bas.
Jalapeño. Le nom a tout d’un clin d’œil : un piment pour une puce qui pique. Derrière l’anecdote se cache l’une des annonces les plus lourdes de conséquences du mois d’août 2026. OpenAI, l’entreprise la plus visible de l’intelligence artificielle mondiale, ne dépend plus à 100 % de Nvidia pour faire tourner ses modèles.
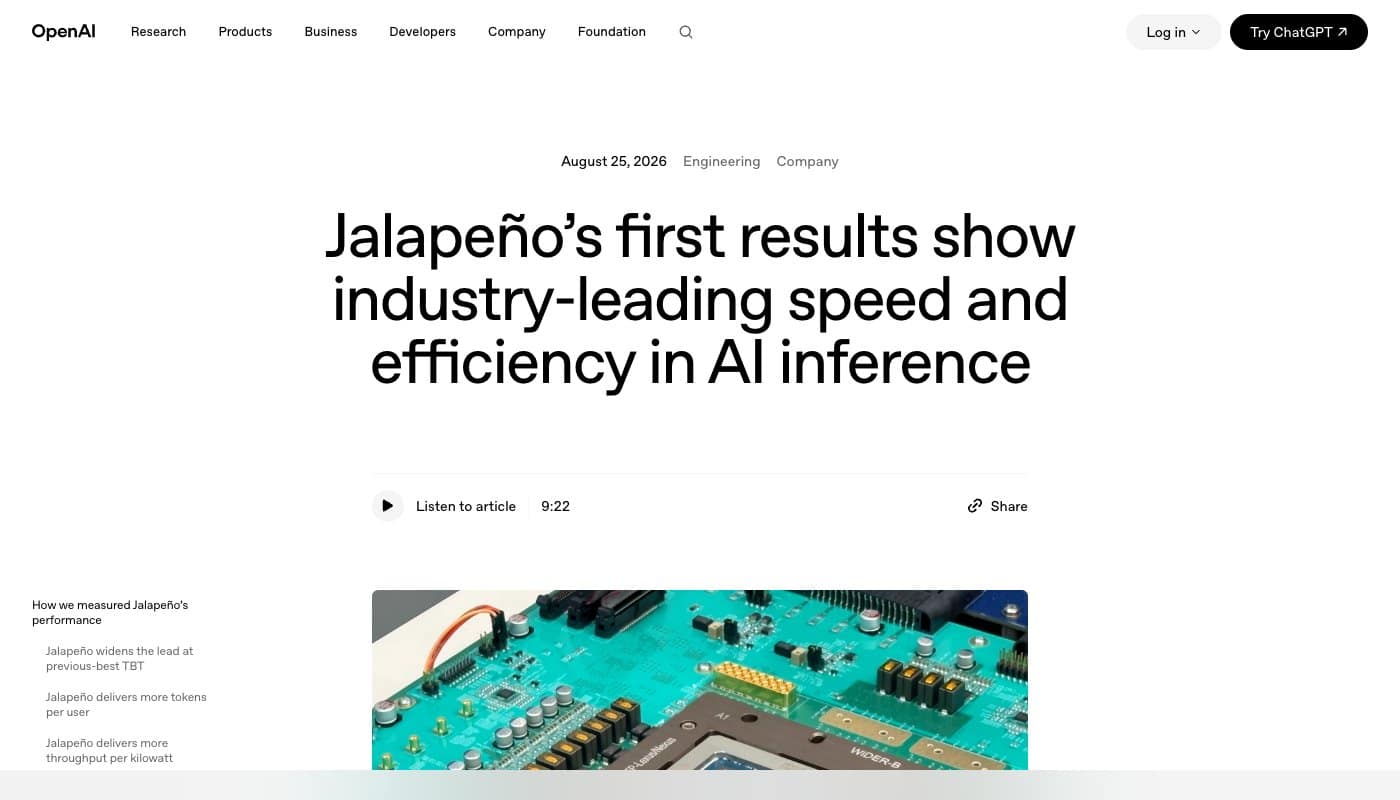
Le 25 août 2026, à 7 h, heure de Greenwich, l’éditeur de ChatGPT a publié une page intitulée « Jalapeño’s first results show industry-leading speed and efficiency in AI inference », autrement dit les tout premiers résultats mesurés de sa puce maison. La même matinée, sa directrice financière Sarah Friar publiait une tribune sur la stratégie de calcul de l’entreprise. Deux textes, un même message : OpenAI veut contrôler toute la chaîne, des modèles jusqu’au silicium.
Pourquoi cela vous concerne, vous, lecteur non technique ? Parce que la vitesse de réponse de ChatGPT, la fiabilité des assistants au quotidien et, à terme, le prix de ces services dépendent de ces machines. Une puce plus efficace, c’est un serveur qui rend plus de réponses par kilowatt, donc, en théorie, une IA moins chère à servir et plus facile à déployer à grande échelle.
Dans cet article, nous avons lu les deux annonces d’OpenAI en entier, vérifié chaque chiffre à la source, et comparé ce qu’elles affirment avec ce que les gros titres en ont retenu.
Que s’est-il passé exactement le 25 août 2026 ?
OpenAI a rendu publics les résultats de tests de Jalapeño sur trois modèles à poids ouverts : GPT-OSS 120B (le modèle à poids ouverts d’OpenAI, 120 milliards de paramètres), DeepSeek R1 670B (670 milliards de paramètres) et Kimi K2.5 1T (mille milliards de paramètres, le plus gros modèle public testé). Le banc d’essai s’appelle InferenceX, un benchmark public développé par SemiAnalysis, qui mesure le processus complet de service d’une requête d’IA, du prompt reçu à la réponse livrée.
Le résultat, selon OpenAI :
« Jalapeño peut traiter plus de travail d’IA par unité de puissance tout en renvoyant les réponses plus rapidement. » (Jalapeño can serve more AI work per unit of power while also returning responses more quickly.)
Et plus précisément :
« Sur les trois modèles, Jalapeño a délivré de 1,5 à 1,9 fois plus de travail d’IA par watt au débit maximal et de 1,7 à 3,6 fois moins de latence de bout en bout que les systèmes comparés. Pour les charges de travail très interactives, il a délivré de 2,1 à 4,1 fois plus de performance. » (Across all three, Jalapeño delivered 1.5 to 1.9 times more AI work per watt at peak throughput and 1.7 to 3.6 times lower end-to-end latency than the comparison systems. For highly interactive workloads, it delivered 2.1 to 4.1 times higher performance.)
L’annonce ne porte pas sur un produit disponible. OpenAI indique prévoir de commencer le déploiement dans son infrastructure de calcul d’ici la fin de l’année, avec une deuxième génération déjà en développement avancé et une troisième en cours de définition. La puce succède à une première annonce, faite le 24 juin 2026 avec Broadcom.
Jalapeño, la puce d’OpenAI : une genèse en trois étapes
Pour comprendre pourquoi cette annonce est un événement, il faut revenir à la date où la puce a été dévoilée. L’entreprise avait annoncé dès 2025 son intention de fabriquer elle-même ses puces, un projet que Yiaho avait décrypté à l’époque.
Retour sur la chronologie :
- 24 juin 2026 : la révélation. OpenAI et Broadcom dévoilent Jalapeño, présenté comme le premier « processeur d’intelligence » d’OpenAI. La puce est un accélérateur spécialisé pour l’inférence des grands modèles de langage, conçu en collaboration avec Broadcom (implémentation silicium, mise en boîtier, réseau haute performance via les puces Tomahawk) et Celestica (cartes, châssis, systèmes). Les échantillons d’ingénierie faisaient déjà tourner en laboratoire des charges de travail, dont GPT-5.3-Codex-Spark, à la fréquence et à la puissance cibles. Mais le communiqué précisait que la puce restait en phase de tests : « Bien qu’OpenAI mesure encore les performances finales, les premiers tests montrent que Jalapeño offrira un rapport performance par watt nettement supérieur à l’état de l’art actuel » (annonce OpenAI/Broadcom du 24 juin, consultée le 26/08/2026).
- 25 août 2026 : les premiers chiffres. Deux mois après la révélation, OpenAI publie les résultats mesurés, tirés du benchmark public InferenceX. C’est l’annonce de ce jour, et le sujet de cet article.
- Fin 2026 : l’entrée en service annoncée. OpenAI annonce vouloir commencer le déploiement dans son infrastructure d’ici la fin de l’année : c’est un projet annoncé, pas une disponibilité actuelle. Les générations 2 et 3 sont déjà au programme des équipes matérielles. (Annonces consultées le 26/08/2026.)
Cette chronologie compte : une puce de ce niveau qui passe de la conception au « tape-out » (le fichier de fabrication) en neuf mois est, selon ses auteurs, du jamais vu à cette échelle.
« Jalapeño a été co-développée, de la conception initiale au tape-out de fabrication, en à peine neuf mois, et le programme représente ce que nous croyons être le cycle de développement d’un ASIC le plus rapide jamais atteint dans les semi-conducteurs avancés. » (Jalapeño was co-developed from initial design to manufacturing tape-out in just nine months, and the custom AI accelerator program represents what we believe to be the fastest ASIC development cycle ever achieved in high-performance advanced semiconductors.)
Le chiffre de 700 watts revient aussi dans la fiche technique. C’est la consommation de référence « package TDP » annoncée, contre 1 200 watts pour l’accélérateur Nvidia GB200 et 1 400 watts pour le GB300, les deux accélérateurs auxquels OpenAI compare sa puce. Ces 700, 1 200 et 1 400 watts sont les puissances de référence des puces et packages, celles qu’OpenAI utilise pour normaliser ses comparaisons (annexe de l’annonce du 25 août, consultée le 26/08/2026) : elles ne représentent pas la consommation complète d’un système ni celle d’un datacenter. Détail remarquable : OpenAI précise que la puissance soutenue mesurée sur les charges testées est restée à 550 watts ou moins.
Le message derrière les chiffres
Greg Brockman, président de l’entreprise, avait donné le ton dès juin :
« Le monde s’oriente vers une économie portée par le calcul. Jalapeño fait partie de notre stratégie d’infrastructure full-stack à long terme pour rendre le calcul plus abondant, avec une IA plus rapide, plus fiable et plus abordable pour les gens et les entreprises. » (Jalapeño is part of our long-term full-stack infrastructure strategy to make compute more abundant, resulting in AI which is faster, more reliable, more affordable for people and businesses, and can be used to solve more important problems.)
Le 25 août, Sarah Friar a poursuivi la même logique :
« Les meilleures économies viennent de l’intelligence utile par dollar. » (The best economics come from useful intelligence per dollar.)
Autrement dit : ce n’est pas la puissance brute qui compte, c’est le travail utile produit par chaque watt et chaque euro investi.
Les chiffres, modèle par modèle : ce que dit la mesure
Avant les tableaux, trois notions de vocabulaire, expliquées simplement.
- L’inférence, c’est le moment où l’IA répond. Quand vous tapez une question dans ChatGPT, des serveurs « infèrent » la réponse. C’est l’étape la plus coûteuse en volume : chaque requête, chaque utilisateur, chaque jour.
- Le débit utilisateur (TBT, time between tokens), c’est le rythme auquel les mots arrivent à l’écran. 535 tokens par seconde par utilisateur, c’est un texte qui défile quasi instantanément ; 169 tokens par seconde reste fluide, mais moins vertigineux. Yiaho avait déjà exploré cette notion dans son décryptage des 750 tokens par seconde de GPT-5.6 Sol en mode Ultrafast.
- Le mode de comparaison, enfin, est essentiel. OpenAI dit évaluer « à expérience utilisateur équivalente » : combien de travail utile chaque système arrive-t-il à accomplir par unité de puissance, tout en tenant le rythme de latence exigé par les usages interactifs.
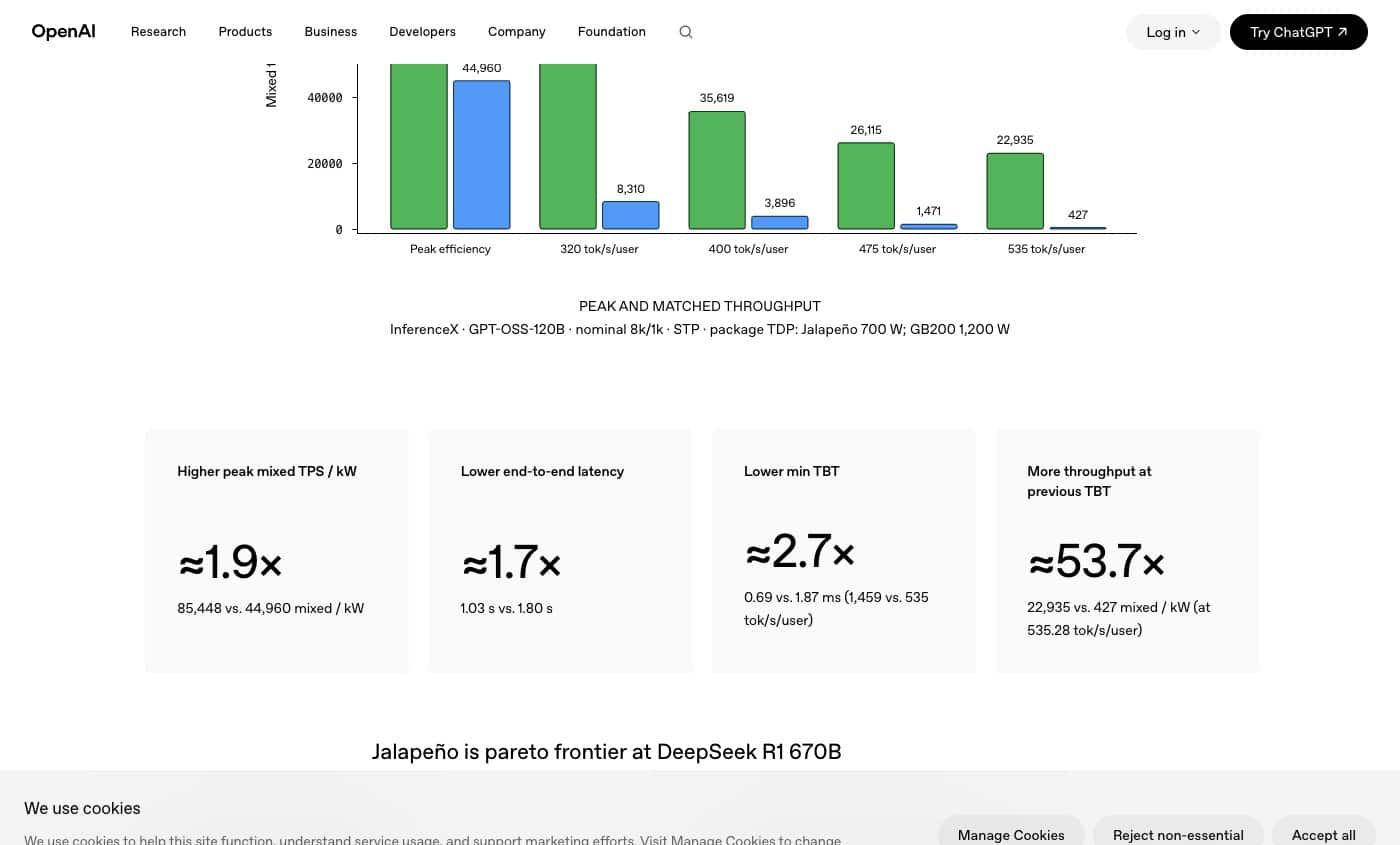
Voici les résultats publiés, tels quels (les ratios sont ceux d’OpenAI) :
| Modèle testé | Puce comparée | Débit maximal par kilowatt | Latence de bout en bout | Rythme utilisateur (TBT minimal) | Débit à rythme utilisateur égal |
|---|---|---|---|---|---|
| GPT-OSS 120B | GB200 (1 200 W) | 85 448 contre 44 960 (environ 1,9 fois) | 1,03 s contre 1,80 s (1,7 fois moins) | 1 459 contre 535 tok/s (0,69 contre 1,87 ms) | 22 935 contre 427 (53,7 fois) |
| DeepSeek R1 670B | GB300 (1 400 W) | 19 641 contre 11 781 (environ 1,7 fois) | 1,65 s contre 5,99 s (3,6 fois moins) | 700 contre 169 tok/s (1,43 contre 5,90 ms) | 12 258 contre 118 (104,3 fois) |
| Kimi K2.5 1T | GB300 (1 400 W) | 18 195 contre 11 862 (environ 1,5 fois) | 1,56 s contre 5,31 s (3,4 fois moins) | 694 contre 182 tok/s (1,44 contre 5,48 ms) | 6 744 contre 120 (56,1 fois) |
Lecture simple du tableau : sur les trois modèles, la puce d’OpenAI tient le coup sur des modèles qu’elle n’a pas entraînés, y compris sur des modèles concurrents comme Kimi ou DeepSeek. OpenAI insiste sur ce point : l’architecture fonctionne au-delà de ses propres modèles. Dans l’annonce du 24 juin, l’entreprise décrivait la puce comme « conçue avec la flexibilité nécessaire pour fonctionner avec tous les LLM » (annonce OpenAI/Broadcom, consultée le 26/08/2026) ; les résultats publiés le 25 août l’ont montrée testée publiquement sur trois familles de modèles : GPT-OSS, DeepSeek R1 et Kimi K2.5.
Sur GPT-OSS 120B, le petit modèle du lot, la comparaison se fait avec le GB200 de 1 200 W. Sur les deux modèles géants, le comparateur est le GB300 de 1 400 W. Le détail qui change la lecture : les deux dernières colonnes comparent les systèmes à expérience utilisateur équivalente, c’est-à-dire à un temps entre tokens (TBT) identique. C’est là que les ratios deviennent importants : ils quantifient un scénario de comparaison donné, pas la vitesse moyenne de la puce.
Le décodeur : quatre questions sur l’annonce
Cliquez sur une question : chaque panneau répond avec les faits vérifiés dans les deux annonces d’OpenAI (24 juin et 25 août 2026).
Quatre questions, quatre réponses sourcées.
Une puce spécialisée dans la réponse
Jalapeño n’est pas un processeur généraliste ni un GPU d’entraînement. C’est un accélérateur spécialisé, taillé pour une seule mission : servir au plus vite les réponses des grands modèles de langage, notamment pour les agents interactifs, qui enchaînent des centaines d’étapes.
Concrètement, la puce minimise les déplacements de données : l’état du modèle et le cache de contexte restent locaux, et le réseau intégré garde toute la charge dans un seul système connecté. OpenAI le résume : l’architecture est conçue pour réussir aussi bien la phase de préremplissage (le prompt) que celle de décodage (la génération mot à mot).
Où c’est écrit : annonce OpenAI du 25 août 2026, sections « How we measured » et « Architecting for speed and efficiency ».
Les chiffres qu’il faut retenir
Sur trois modèles publics, de 1,5 à 1,9 fois plus de travail d’IA par watt au débit maximal, et latence de bout en bout réduite de 1,7 à 3,6 fois. Sur les charges très interactives, le gain monte à 2,1-4,1 fois.
À expérience utilisateur équivalente, le rapport devient important : 22 935 contre 427 débits mixtes par kilowatt sur GPT-OSS, 12 258 contre 118 sur DeepSeek R1, 6 744 contre 120 sur Kimi K2.5. C’est de là que sortent les « 53,7 fois », « 56,1 fois » et « 104,3 fois » des tableaux. Ces ratios comparent les deux systèmes à un temps entre tokens (TBT) identique : ils ne signifient pas que Jalapeño est globalement 50 ou 100 fois plus rapide.
La consommation annoncée est de 700 watts pour Jalapeño, contre 1 200 watts pour le GB200 et 1 400 watts pour le GB300. Ce sont les puissances de référence des puces (package TDP) dans la normalisation d’OpenAI, pas la consommation complète d’un système ni celle d’un datacenter. La puissance soutenue mesurée, elle, est restée inférieure ou égale à 550 watts.
Où c’est écrit : annexe de l’annonce OpenAI du 25 août 2026, trois fiches « InferenceX » (GPT-OSS 120B, DeepSeek R1 670B, Kimi K2.5 1T).
Nvidia reste dans la boucle
La page du 25 août le dit sans ambiguïté : « Nous continuerons à déployer massivement des accélérateurs de NVIDIA et d’autres partenaires, pour l’entraînement comme pour l’inférence. » (We will continue to widely deploy accelerators from NVIDIA and other partners for both training and inference workloads.)
La puce maison ne remplace donc pas Nvidia : elle ajoute une option dans un portefeuille qui inclut déjà Microsoft, AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SB Energy et SoftBank, liste donnée par Sarah Friar le 25 août, prolongeant des accords comme le méga deal puces signé avec AMD.
En revanche, la dynamique change : OpenAI peut désormais orienter chaque charge vers la meilleure économie, et négocier avec ses fournisseurs en ayant une alternative crédible en interne.
Où c’est écrit : annonce OpenAI du 25 août 2026 (section « The path ahead ») et tribune de Sarah Friar du même jour (section « Build for breadth, own for leverage »).
Ce qui change pour l’utilisateur
OpenAI promet trois effets directs : des réponses plus rapides, des agents plus réactifs, et un accès plus fiable quand la demande est forte. C’est la traduction utilisateur de la performance par watt.
Sarah Friar va plus loin en évoquant le paradoxe de Jevons : « une efficacité accrue rend plus d’usages rentables, ce qui élargit la consommation et crée une nouvelle activité économique » (greater efficiency makes more uses worthwhile, expanding consumption). Autrement dit : plus l’IA devient efficace à servir, plus les entreprises en trouveront des usages.
Rien ne dit, en revanche, que la baisse des coûts internes se traduira par une baisse des prix publics. OpenAI ne fait aucune annonce tarifaire le 25 août : la promesse est une IA plus abordable, pas une baisse de prix annoncée pour demain.
Où c’est écrit : annonce du 25 août 2026 (introduction et section « The path ahead »), tribune de Sarah Friar (section « Turning efficiency into economic value »).
1,9 fois, 53,7 fois, 104,3 fois : les gros titres et les chiffres
La couverture de l’annonce a été considérable. La presse spécialisée française, comme ZDNET, a titré que « le premier processeur d’OpenAI devancerait Nvidia en efficacité et rapidité », reprenant les chiffres officiels. La presse anglophone a parlé d’une puce de 700 watts qui « surclasse » le GPU phare de 1 400 watts, avec « jusqu’à 1,9 fois » plus de débit par watt.
Ces gros titres ne sont pas faux, mais ils mélangent deux mesures très différentes.
La mesure n° 1 : au pic de débit, l’écart est de 1,5 à 1,9 fois
C’est la mesure la plus simple : chacun fait tourner ses serveurs à fond, et on compare le travail rendu. Selon le modèle, Jalapeño rend 1,5, 1,7 ou 1,9 fois plus de travail par watt. Le « 1,9 fois » des titres correspond au cas GPT-OSS 120B, le plus favorable.
La mesure n° 2 : à rythme utilisateur égal, l’écart explose
OpenAI a aussi forcé les deux systèmes à répondre au même rythme : celui du meilleur système existant, soit un temps entre tokens identique entre les deux puces. Résultat, sur DeepSeek R1 : 12 258 débits par kW pour Jalapeño, contre 118 pour le GB300. D’où le « 104,3 fois » : le ratio d’un scénario à expérience utilisateur équivalente, pas un indice de vitesse globale.
Pourquoi un tel écart ? Parce que le comparateur Nvidia ne tient pas ce rythme : à 169 tokens par seconde et par utilisateur, son débit par watt s’effondre, alors que la puce d’OpenAI garde le cap. Le « 104 fois » est donc un chiffre vrai dans un cadre précis : celui où l’on exige du système existant une rapidité qu’il ne peut pas fournir confortablement.
Le piège de la lecture
Trois précautions avant de comparer ce chiffre au « 104 fois » d’autres annonces :
- Les chiffres sont publiés par le fabricant lui-même. Le benchmark est public et indépendant, mais le choix des points de mesure, la normalisation et la présentation appartiennent à OpenAI.
- La normalisation est faite sur les consommations annoncées. Jalapeño est compté à 700 watts, alors que la mesure réelle est à 550 watts ou moins : la comparaison est donc prudente pour OpenAI, pas l’inverse.
- Les tests portent sur des modèles à poids ouverts. Sur ses modèles propriétaires, OpenAI dit que « l’avantage se creuse » en interne, mais sans publier de chiffres.
Une chose est sûre : la promesse n’est pas « la puce est 100 fois plus rapide ». Elle est : « à puissance égale, nous servons davantage d’utilisateurs, plus vite, et nous croyons le coût unitaire plus bas ». C’est déjà considérable, mais ce n’est pas la même phrase.
L’IA qui a conçu la puce qui fait tourner l’IA
L’annonce contient une deuxième histoire, plus vertigineuse que la première : selon OpenAI, ses modèles ont activement participé à la conception de la puce.
- Neuf mois du premier dessin au tape-out, grâce à des cycles de conception, de mesure et de vérification raccourcis par les modèles, qui ont aussi optimisé les circuits arithmétiques.
- Trois modèles à poids ouverts mis à niveau en deux mois avec Codex et GPT-Astra, alors qu’ils ne faisaient pas partie du plan initial de production de la puce.
- Des implémentations écrites par IA plus rapides que celles des experts : sur certains blocs d’attention et de mélange d’experts de GPT-OSS, de 1,5 à 1,8 fois plus rapides que les versions écrites à la main. Précision importante : ces gains concernent des blocs choisis, pas le modèle entier.
Autrement dit, la boucle est bouclée : les mêmes modèles servis aux utilisateurs aident à concevoir l’infrastructure qui sert les modèles de demain. OpenAI le formule comme un principe : « Nous avons utilisé l’IA pour concevoir la puce, et nous avons conçu la puce pour que l’IA puisse la programmer » (We used AI to design the chip, and designed the chip so AI could program it).
Le 24 juin, l’entreprise résumait l’ambition d’une phrase que peu de reprises ont citée :
« Si l’IA peut aider les ingénieurs à concevoir de meilleures puces plus rapidement, elle peut réduire le coût du calcul dans toute l’industrie et contribuer à démocratiser l’accès à l’IA avancée. » (If AI can help engineers design better chips faster, it can lower the cost of compute across the industry and help democratize access to advanced AI.)
Pour comprendre cette mécanique sans jargon, le guide complet de l’IA de Yiaho détaille ce qu’est un modèle, un paramètre et un serveur d’inférence.
Ce que l’annonce ne prouve pas, encore
Une annonce de ce niveau mérite d’être lue avec ses limites. En voici la liste, telle que nous avons pu la vérifier.
- Les chiffres viennent d’OpenAI. Le benchmark InferenceX est indépendant et public, mais la sélection des points de fonctionnement et la communication des résultats sont celles du fabricant.
- Un seul benchmark. InferenceX mesure le service de requêtes ; il ne dit rien de l’entraînement, qui reste massivement sur GPU Nvidia.
- Trois modèles à poids ouverts. Les modèles propriétaires d’OpenAI, les plus critiques pour son activité, ne sont pas couverts par des chiffres publiés.
- Le déploiement n’a pas commencé. « D’ici la fin de l’année » reste une intention ; la qualification de production, la maturation logicielle et la validation à grande échelle sont encore en cours, selon les mots mêmes d’OpenAI.
- Les générations suivantes sont au stade de projet. La Gen 2 est « en développement avancé », la Gen 3 « prend forme » : rien n’est livré.
- Pas de promesse tarifaire publique. Sarah Friar parle de « levier opérationnel » et de « coût total du travail réussi », pas d’un prix affiché pour les abonnements.
Retenons aussi un point rarement signalé : OpenAI n’a pas encore publié de rapport technique détaillé. En juin, l’entreprise promettait « un rapport technique détaillé sur les performances sera présenté dans les mois à venir » (A detailed technical report on performance will be presented in the coming months.) ; la page du 25 août présente des graphiques et des chiffres, mais pas de méthodologie complète.
Et pour vous, concrètement ?
À court terme, rien ne change à l’écran. La puce n’est pas en service, et les gains mesurés en laboratoire ne se voient pas dans votre ChatGPT de ce soir.
À moyen terme, si le rythme de déploiement se tient, trois effets sont plausibles :
- Des réponses plus rapides. Le rythme utilisateur est justement le champ où la puce écrase la concurrence à puissance égale. Les modes « rapides » pourraient monter en débit sans consommer plus.
- Des agents plus ambitieux. Un agent qui enchaîne des centaines d’étapes est sensible à chaque milliseconde : moins de latence, c’est des workflows plus longs qui deviennent viables.
- Une pression sur les coûts. Si l’inférence devient moins chère à servir, la concurrence sur les prix ou sur la gratuité des usages d’entrée de gamme peut s’accentuer. C’est précisément le terrain de bataille où Yiaho joue déjà, avec une IA en ligne gratuite et sans inscription, au moment même où les grandes références comme GPT-5.6 se déploient partout dans le monde.
Il faut néanmoins rester mesuré : le secteur raconte que l’énergie et les puces manquent, et tout gain d’efficacité est aussitôt repris par de nouveaux usages, et OpenAI elle-même a été vue en train de ralentir certains investissements pour maîtriser ses coûts, comme le montrait notre décryptage du 18 août. C’est le paradoxe de Jevons, cité par Sarah Friar elle-même. La baisse du coût unitaire ne signifie pas une facture d’électricité mondiale en baisse.
FAQ : vos questions sur Jalapeño
Une puce d’inférence, c’est quoi, en clair ?
Quand vous posez une question à une IA, des serveurs « infèrent » la réponse : c’est l’inférence. Une puce d’inférence est un circuit spécialisé pour faire ce travail le plus vite et le plus économe possible. Elle ne sert pas à entraîner les modèles, tâche qui reste dévolue aux GPU de Nvidia et aux autres accélérateurs d’entraînement.
OpenAI va-t-il abandonner Nvidia ?
Non. La page du 25 août dit explicitement qu’OpenAI continuera de déployer massivement des accélérateurs Nvidia, pour l’entraînement comme pour l’inférence. La puce maison s’ajoute à un portefeuille déjà diversifié (Microsoft, AWS, AMD, Broadcom, Cerebras, CoreWeave, Oracle, SoftBank, entre autres). Ce qui change, c’est le rapport de force et la marge de manœuvre économique.
Le chiffre de « 104 fois » est-il réel ?
Oui, mais dans un cadre précis. Sur DeepSeek R1 670B, à rythme utilisateur égal, Jalapeño rend 12 258 débits mixtes par kilowatt contre 118 pour le GB300, soit environ 104,3 fois. Ce « 104 fois » compare des scénarios à expérience utilisateur équivalente, à même temps entre tokens pour les deux systèmes : il ne mesure pas la performance moyenne de la puce et ne signifie pas qu’elle est globalement 100 fois plus rapide. À pic de débit, le gain sur le même modèle est d’environ 1,7 fois.
Quand cette puce sera-t-elle utilisée par ChatGPT ?
OpenAI indique vouloir commencer le déploiement dans son infrastructure « d’ici la fin de l’année », avec une montée en charge dans les mois suivants. La puce n’est pas encore en service : c’est un projet annoncé, sans date précise, et la qualification de production est encore en cours.
Est-ce que le prix de ChatGPT va baisser ?
OpenAI ne l’annonce pas. L’entreprise parle d’IA « plus abordable et plus largement disponible », et sa directrice financière évoque un coût total plus bas par travail réussi. C’est une direction, pas une promesse tarifaire. La baisse du coût de service peut aussi financer davantage de recherche ou de nouveaux usages.
Pourquoi le nom « Jalapeño » ?
OpenAI n’a pas expliqué le choix du nom dans ses annonces. C’est un piment mexicain, et la puce est comparée à des systèmes nettement plus gros et plus gourmands. L’ironie du nom, si ironie il y a, reste non commentée par l’entreprise.
En un mot
Le 25 août 2026, OpenAI rapporte des résultats mesurés sur sa propre puce d’inférence, qui tiennent face aux meilleurs accélérateurs du marché à puissance égale, sur les trois familles de modèles testées publiquement. Ce n’est ni la fin de Nvidia, ni une révolution visible dès demain : c’est l’instauration d’un nouveau rapport de force, et l’une des pièces d’un puzzle plus vaste où l’IA contribue à concevoir l’infrastructure qui la fait tourner.
Pendant que les géants construisent leurs puces, les IA grand public sont déjà là, et se comparent sur le terrain qui compte vraiment : la qualité et la rapidité des réponses, sans abonnement ni compte à créer. C’est exactement le test que vous pouvez faire dès maintenant sur l’IA de Yiaho.
Testez l’IA de Yiaho, gratuitement
Une IA en ligne, en français, sans inscription, avec des réponses immédiates. Le prochain modèle n’a pas besoin d’attendre : la page d’accueil de Yiaho vous permet de comparer par vous-même ce que vaut une IA générique.